AI Rapper:建立属于自己的舞台人物形象
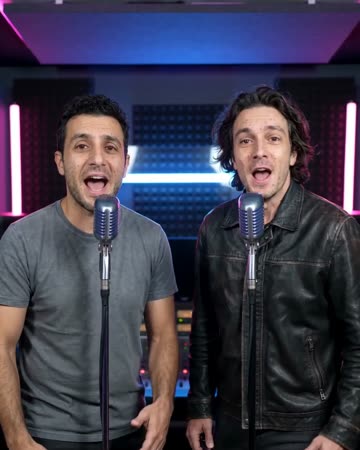
舞台人物首先取决于如何占据画面。这个预设把你的人像放在简洁舞台中央,以轻微推进和自然手势建立存在感。预设会请求原创说唱人声与舞台伴奏。
适合艺人资料页形象试验、动态自我介绍或封面揭晓。可以按信息流小尺寸观看,判断角色是否仍然容易辨认。
看清这个效果的特点
让舞台角色仍然像你
柔和夜色衬托话筒前的主角,自然手势和轻微推进建立舞台存在感。重点是保留原照人物,而不是借用某位名人的身份。
让构图保持清楚
有特点的服装和清楚轮廓就能支撑角色,不必借用知名艺人的身份。源照片的表情应当与你希望建立的个人创作形象一致。
新制作的声音方向
模型提供简短原创说唱和节拍,不会从照片训练持续歌手身份或克隆你的真实声音。
按剪辑用途选择规格
新草稿从 12 秒、720p、9:16 竖屏开始。Advanced 展示模型及其支持的时长、清晰度和画幅;提交前查看总积分,实际选项以所选模型为准。
从照片到成片的制作过程
可以使用单人或合照;需要双人时也能选择分开来源。生成前确认构图和当前参数。
确定角色气质
先判断角色应该克制、自信,还是轻松活泼。
检查辨识线索
检查镜头靠近时的脸部、服装轮廓与站姿。
形成一致的介绍
外部加入艺名和选定声音,并与其他个人资料保持一致。
这段画面,可以怎么用
创作者形象测试
先看服装和表情在短表演中的效果,再决定是否用于更大的内容企划。
动态人物卡
在表演后加入姓名和身份说明,让动态人物卡有准确背景。
按这个动作准备来源照片
- 选作为角色主体的人物本人照片。
- 让有辨识度的服装在上半身可见。
- 避免背景细节抢走面部注意力。
视觉形象不等于自动运营的艺人、克隆人声或持续角色记忆。不同生成之间,服装与面部细节仍可能变化。
常见问题
会自动创造完整虚拟艺人吗?
这里生成一段带原创说唱的舞台表演,但不自动建立艺人生平、长期角色记忆或持续作品体系。不同视频仍需核对形象与声音的一致性。
以后会自动记住这个角色吗?
每次依据当次照片和设置生成,没有持续角色记忆控制;不同片段的衣着和面部细节需要自行核对。
会复制明星声音吗?
会请求原创说唱人声和节拍,配合源人像的舞台表演;这不是对照片中本人或某位明星的声音克隆。
怎么判断舞台形象是否成立?
先关掉字幕看画面。如果脸部、姿态和服装已经能传达预定气质,视觉基础就更明确。
可以使用双人照片吗?
可以,也能切换为两张来源;生成后需要分别检查两人的相似度和表演时机。
在哪里查看费用,失败后积分怎么办?
生成按钮显示所选模型和输出设置的总积分。创建任务时扣除积分,确认失败的任务返还所扣积分。提交前查看实际总额,不要假设所有模型费用相同。
再看一种不同的方向

AI 说唱表演生成
有声表演 · 照片转视频
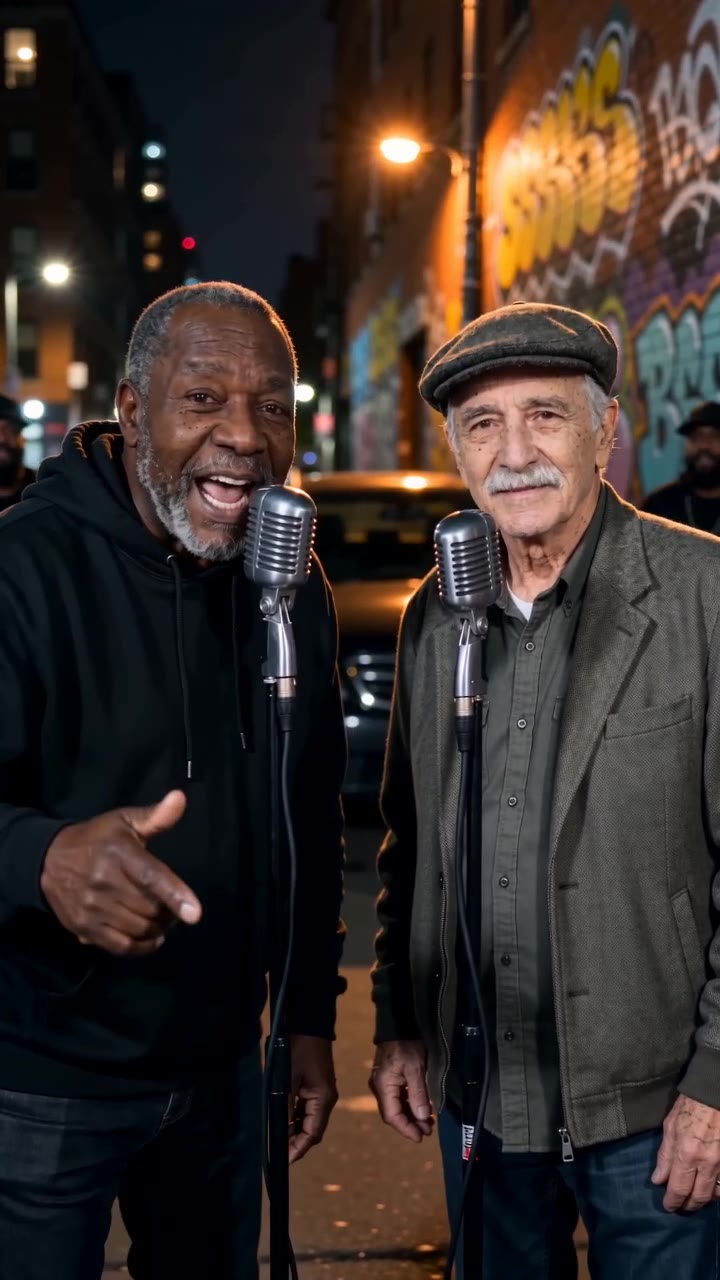
柔和夜景中,人物分别站在话筒前。先由一人带出简短唱段;有第二位主角时,对方会回应并接过下一轮。
把自己做成 AI 视频
个人介绍
镜头从来源人物近处开始,升过街道和海岸、穿过云层,以完整地球收尾。你的脸负责引出旅程,不会全程占据大画面。
AI 录音棚表演
有声表演 · 照片转视频
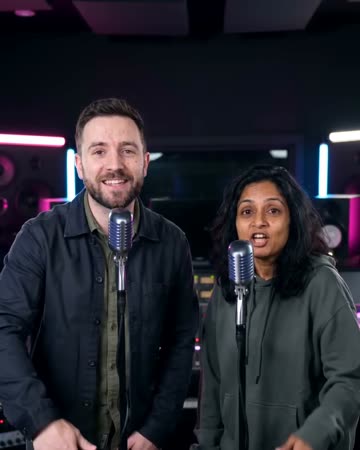
深色录音间与柔和轮廓光衬托话筒前的自然动作,器材保持虚化,让嘴部、手势和表情承担近距离表演。
AI 虚拟说唱表演
先判断角色应该克制、自信,还是轻松活泼。
制作这个效果