
AI 说唱画面:为自己的歌词准备表演镜头
这个页面解决的是歌词背后的表演画面:人物站在话筒前,保持可辨认的五官,以适量肩部动作和手势表达情绪,为歌词剪辑提供观看主体。预设会请求原创短说唱、人声与节拍。
适合歌词节选、单段说唱预告或个人 Demo。可与真实近景交替使用,避免让一段生成镜头承担整首歌的全部叙事。
看清这个效果的特点
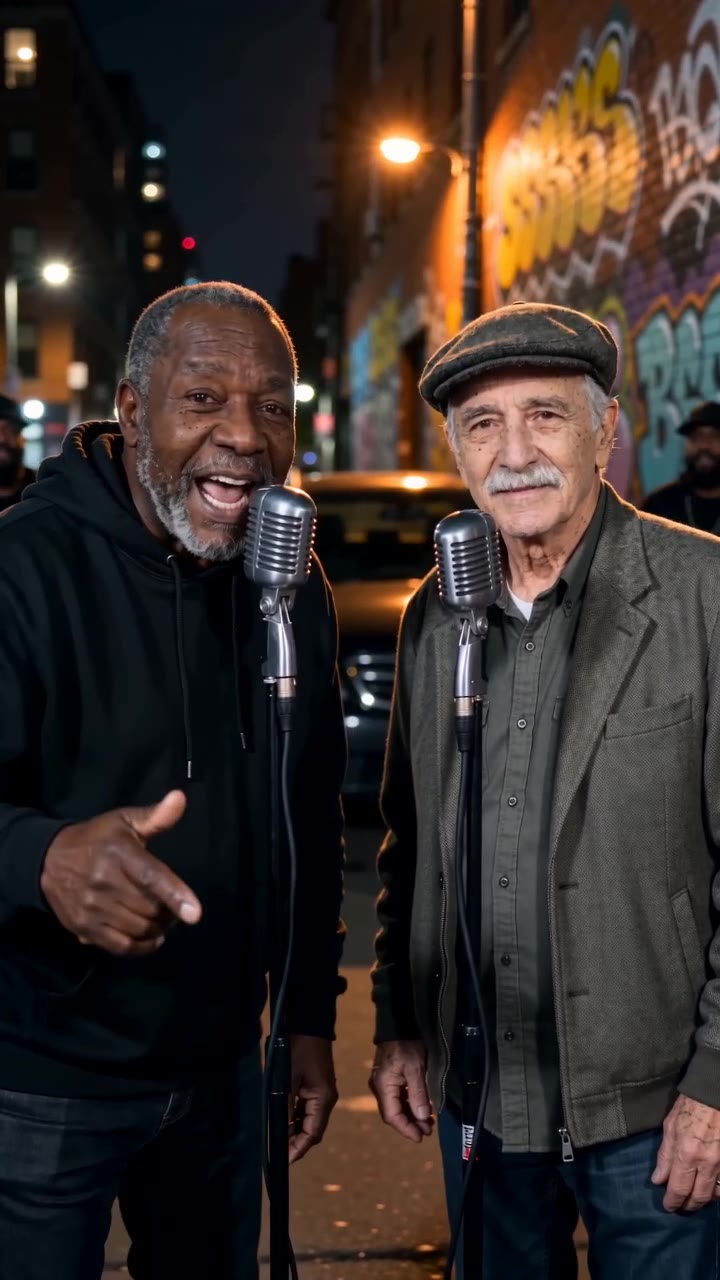
夜色街头的一段说唱
柔和夜景中,人物分别站在话筒前。先由一人带出简短唱段;有第二位主角时,对方会回应并接过下一轮。
让构图保持清楚
预设把人像、舞台动作和一小段原创说唱一起生成。短镜头优先保留清楚的人声与可读的手势关系;如果需要指定故事、姓名或整首歌词,当前表单没有相应的定制输入。
新制作的声音方向
画面配有简短原创说唱与节拍,表单不接收歌词文件或伴奏上传。
按剪辑用途选择规格
新草稿从 12 秒、720p、9:16 竖屏开始。Advanced 展示模型及其支持的时长、清晰度和画幅;提交前查看总积分,实际选项以所选模型为准。
从照片到成片的制作过程
可以使用单人或合照;需要双人时也能选择分开来源。生成前确认构图和当前参数。
先确定段落情绪
先选清楚人像并确认镜头用途;预设会生成原创短说唱,准确姓名与专属文案可在下载后用字幕补充。
检查话筒前表演
核对脸形与手部运动,重点看话筒和嘴部重叠的位置。
把歌词段落放进画面
回听生成的人声与节拍,检查发音和口型;按实际短句添加字幕,必要时继续剪辑。
这段画面,可以怎么用
新段落预告
用街头镜头预告新内容,准确日期和名称通过清晰的后期图文补充。
合作提案演示
把短表演与文字方案一起发给合作者,讨论构图和氛围。
按这个动作准备来源照片
- 嘴部不要被口罩、手或深阴影遮挡。
- 正脸或轻侧脸更便于辨认表情。
- 保留一定上半身,给肩部和手势留位置。
模型会请求所选时长内的短说唱、人声与节拍,并非整首录音。当前不支持上传歌词或音轨指定逐字演唱;需要回放检查发音和口型。
常见问题
这个页面会替我写一首说唱吗?
会请求一小段原创说唱、人声与伴奏,长度受所选视频时长限制。表单没有自定义歌词项,也不交付单独的完整歌词文件或整首歌曲。
能上传歌曲自动同步嘴型吗?
当前表单接收照片,不接收歌曲文件。预设会生成自己的音轨并请求同步口型;它不会自动分析或严格跟随你在外部准备的歌曲。
应该用大头照还是半身照?
半身照能给肩膀和双手留出表达空间;过紧的大头照较难体现这些表演线索。
它与 Rap Maker 的侧重点有什么不同?
这里侧重清楚的说唱人声与麦克风表演;Rap Maker 更适合先试一个短hook和舞台构思。两者都开启原生音频,具体内容由各自预设生成。
这是完整歌曲生成器吗?
输出是带简短说唱的视频,没有整曲编排或逐字编辑时间线。
可以一直保留单人吗?
使用单人照片即可,预设保留一位原始主角,不会把另一张不存在的来源当作第二位领唱。
在哪里查看费用,失败后积分怎么办?
生成按钮显示所选模型和输出设置的总积分。创建任务时扣除积分,确认失败的任务返还所扣积分。提交前查看实际总额,不要假设所有模型费用相同。
再看一种不同的方向
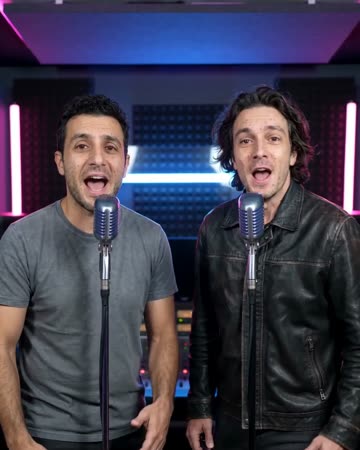
AI 虚拟说唱表演
有声表演 · 照片转视频
柔和夜色衬托话筒前的主角,自然手势和轻微推进建立舞台存在感。重点是保留原照人物,而不是借用某位名人的身份。
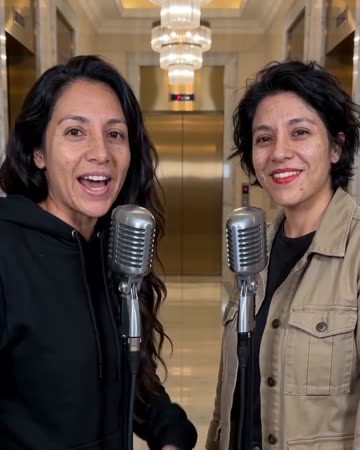
Rap Maker 有声说唱
有声表演 · 照片转视频
人物在大理石大厅的吊灯下站到话筒前,以肩部和手部小动作配合简短乐句。双人可以轮流表演,最后共同微笑。
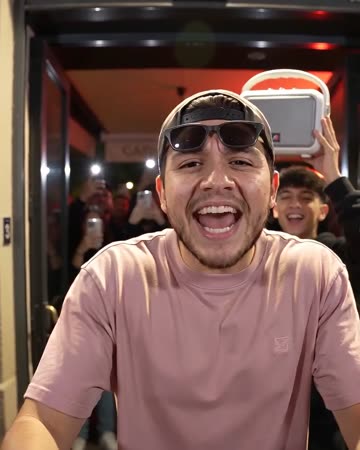
AI 街头 Cypher
有声表演 · 照片转视频
红光餐厅门外,前景主角面对近距离手持镜头表演,后方同伴举起小音箱回应,让街头画面有明确的前后分工。
AI 说唱表演生成
先选清楚人像并确认镜头用途;预设会生成原创短说唱,准确姓名与专属文案可在下载后用字幕补充。
制作这个效果